Pourquoi la donnée QHSE reste sous-exploitée ?
Un chiffre résume bien l'enjeu : 20% des accidents graves surviennent au cours de la première année de prise de poste, selon un communiqué de la FNATH publié en novembre 2025.
Ce type de récurrence reste pourtant difficile à détecter avec des outils classiques, causeries, affichages, audits trimestriels, qui ont montré leurs limites face à la complexité systémique des environnements de travail modernes. La donnée existe presque toujours, elle n'est simplement jamais rapprochée d'assez d'autres données pour révéler ce schéma.
D'où vient réellement la donnée QHSE ?
Avant de parler d'analyse, il faut d'abord cartographier les sources. Une entreprise génère typiquement de la donnée QHSE à travers ses déclarations d'accidents et d'incidents, ses audits internes et externes, ses non-conformités et plans d'action, ses indicateurs environnementaux, ses formations et habilitations, et ses remontées terrain via application mobile. Prise isolément, chacune de ces sources raconte une histoire partielle. Reliées entre elles, elles permettent de voir des schémas invisibles au niveau d'un seul indicateur.
De l'analyse descriptive à l'analyse prédictive
La différence entre une démarche QHSE traditionnelle et une démarche appuyée sur la donnée massive tient en une question. L'analyse descriptive répond à "pourquoi c'est arrivé", en général via un arbre des causes construit après l'événement. L'analyse prédictive répond à "où cela risque d'arriver demain", en croisant en continu des variables qui semblaient sans lien apparent : conditions météo, cadences de production, cycles de maintenance des machines. Un rapport manuel qui prenait auparavant des semaines de compilation Excel devient, une fois les données centralisées, une analyse quasi instantanée.
Le gain ne se limite pas au temps gagné. Une entreprise qui détecte une dérive de comportement en temps réel peut arrêter la situation dangereuse avant l'accident, plutôt que de l'analyser après coup. C'est ce déplacement, du constat vers l'anticipation, qui distingue réellement une démarche Big Data QHSE d'un simple tableau de bord d'indicateurs.
Trois étapes pour construire une démarche solide
Centraliser avant d'analyser
Aucune analyse sérieuse n'est possible tant que les données restent réparties sur plusieurs outils déconnectés. La première étape consiste à regrouper les sources identifiées dans un référentiel commun, avec une structure homogène : mêmes champs, mêmes unités, même façon de qualifier un événement d'un site à l'autre.
Croiser les données plutôt que les empiler
Une fois centralisées, les données prennent de la valeur quand elles sont croisées entre elles. Un taux d'accidents rapproché des données de formation peut révéler qu'un site sous-forme ses équipes sur un risque précis. Un taux de non-conformités qualité rapproché du taux de rotation du personnel peut révéler un lien que personne n'avait formalisé.
Passer du constat à la prédiction
La dernière étape, souvent la plus ambitieuse, consiste à utiliser l'historique pour anticiper plutôt que pour seulement documenter. Repérer qu'un type d'incident se répète systématiquement dans certaines conditions permet d'agir avant l'accident suivant, plutôt que de continuer à en analyser les causes après coup.
Une donnée sensible, à traiter avec les précautions du RGPD
Construire une démarche Big Data QHSE suppose de manipuler des données de santé, d'accidents et parfois de handicap, qui sont des données sensibles au sens de l'article 9 du RGPD. Deux précautions s'imposent avant même de croiser la moindre donnée. La première consiste à choisir la bonne base légale : le consentement du salarié n'est presque jamais adapté, en raison du lien de subordination qui l'unit à son employeur. La seconde consiste à anonymiser ou pseudonymiser les données avant tout traitement à grande échelle, pour qu'une analyse de récurrence reste possible sans exposer l'identité des personnes concernées.
Nous détaillons ces méthodes d'anonymisation, la question du consentement au travail et le lien avec l'AI Act pour les systèmes prédictifs appliqués à la sécurité, dans notre livre blanc sur l'IA et la sécurité au travail.
L'erreur à éviter en démarrant
La tentation la plus fréquente consiste à vouloir tout construire d'un coup : un entrepôt de données complet, des tableaux de bord sophistiqués, des modèles prédictifs élaborés. Cette approche mène presque toujours à un projet qui s'enlise avant même sa première itération utile. Mieux vaut démarrer sur un périmètre restreint, un site ou une famille de risques, valider que le croisement de données produit des enseignements réellement actionnables, puis étendre progressivement la démarche.
Comment un logiciel QHSE prépare le terrain ?
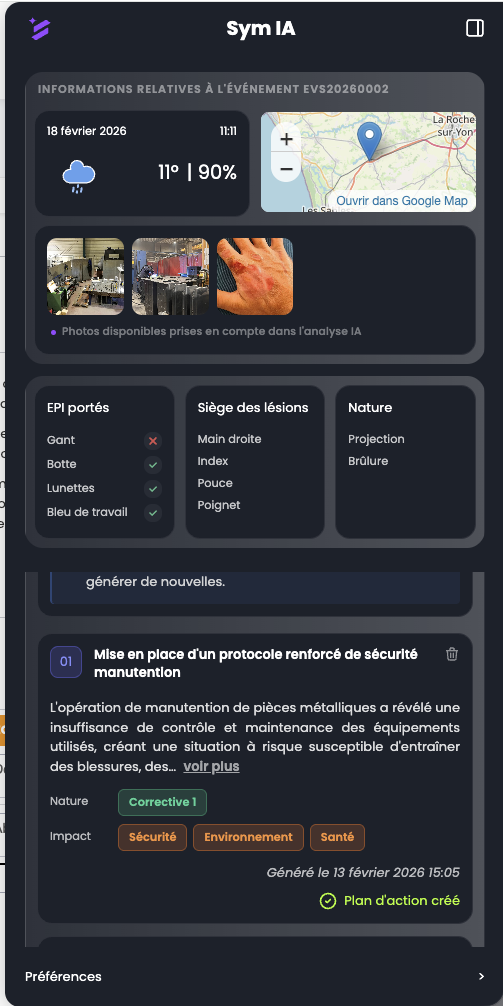
Une démarche Big Data QHSE ne peut pas reposer sur des données saisies dans des formats différents selon les équipes et les sites. Le module Pilotage QHSE de Symalean centralise nativement les non-conformités, les audits, les indicateurs et les plans d'action dans une structure homogène, avec l'IA Sym AI qui peut faciliter la détection de causes récurrentes sur l'historique déjà collecté. C'est précisément ce socle structuré qui rend une exploitation avancée des données possible par la suite, plutôt qu'un obstacle permanent à surmonter.