¿Por qué los datos QHSE siguen estando infrautilizados?
Una cifra resume bien el desafío : el 20% de los accidentes graves ocurren durante el primer año de incorporación al puesto, según un comunicado de la FNATH publicado en noviembre de 2025.
Sin embargo, este tipo de recurrencia sigue siendo difícil de detectar con las herramientas clásicas (charlas, carteles, auditorías trimestrales), que han demostrado sus límites frente a la complejidad sistémica de los entornos laborales modernos. Los datos casi siempre existen; simplemente nunca se cruzan con suficientes fuentes adicionales para revelar este patrón.
¿De dónde provienen realmente los datos QHSE?
Antes de hablar de análisis, primero hay que mapear las fuentes. Una empresa genera datos QHSE habitualmente a través de sus declaraciones de accidentes e incidentes, auditorías internas y externas, no conformidades y planes de acción, indicadores ambientales, formaciones y habilitaciones, y reportes de campo mediante aplicaciones móviles. Tomada de forma aislada, cada una de estas fuentes cuenta una historia parcial. Al conectarlas entre sí, es posible observar patrones invisibles a nivel de un solo indicador.
Del análisis descriptivo al análisis predictivo
La diferencia entre un enfoque QHSE tradicional y uno basado en el análisis masivo de datos se resume en una pregunta. El análisis descriptivo responde a "¿por qué ocurrió?", generalmente mediante un árbol de causas construido después del evento. El análisis predictivo responde a "¿dónde es probable que ocurra mañana?", cruzando continuamente variables que parecían no tener relación aparente: condiciones meteorológicas, ritmos de producción o ciclos de mantenimiento de maquinaria. Un informe manual que antes requería semanas de compilación en Excel se convierte, una vez centralizados los datos, en un análisis casi instantáneo.
El beneficio no se limita al ahorro de tiempo. Una empresa que detecta una desviación de comportamiento en tiempo real puede detener una situación peligrosa antes de que ocurra un accidente, en lugar de analizarla a posteriori. Es este cambio, del diagnóstico a la anticipación, lo que realmente distingue a un enfoque de Big Data en QHSE de un simple panel de indicadores.
Tres pasos para construir un enfoque sólido
Centralizar antes de analizar
No es posible realizar un análisis serio mientras los datos permanezcan dispersos en varias herramientas desconectadas. El primer paso consiste en agrupar las fuentes identificadas en un repositorio común, con una estructura homogénea: mismos campos, mismas unidades y la misma forma de calificar un evento de un centro a otro.
Cruzar los datos en lugar de acumularlos
Una vez centralizados, los datos adquieren valor cuando se cruzan entre sí. Comparar la tasa de accidentes con los datos de formación puede revelar que un centro no está capacitando lo suficiente a sus equipos sobre un riesgo específico. Relacionar la tasa de no conformidades de calidad con la tasa de rotación de personal puede desvelar un vínculo que nadie había formalizado.
Pasar del diagnóstico a la predicción
La última etapa, a menudo la más ambiciosa, consiste en utilizar el histórico para anticipar en lugar de limitarse a documentar. Identificar que un tipo de incidente se repite sistemáticamente bajo ciertas condiciones permite actuar antes del próximo accidente, en lugar de seguir analizando sus causas después de que ocurra.
Datos sensibles que deben tratarse con las precauciones del RGPD
Construir un enfoque de Big Data en QHSE implica manipular datos de salud, accidentes y, a veces, de discapacidad, los cuales son datos sensibles según el artículo 9 del RGPD. Se requieren dos precauciones antes incluso de cruzar el primer dato. La primera consiste en elegir la base legal adecuada : el consentimiento del empleado casi nunca es apropiado debido al vínculo de subordinación que lo une a su empleador. La segunda consiste en anonimizar o seudonimizar los datos antes de cualquier procesamiento a gran escala, para que el análisis de recurrencia siga siendo posible sin exponer la identidad de las personas afectadas.
Detallamos estos métodos de anonimización, la cuestión del consentimiento en el trabajo y su relación con la Ley de IA para los sistemas predictivos aplicados a la seguridad en nuestro libro blanco sobre IA y seguridad laboral.
El error que debe evitar al empezar
La tentación más frecuente es querer construirlo todo de una vez : un almacén de datos completo, cuadros de mando sofisticados y modelos predictivos complejos. Este enfoque casi siempre lleva a que el proyecto se estanque antes incluso de su primera iteración útil. Es mejor empezar con un alcance limitado, ya sea un centro o una familia de riesgos, validar que el cruce de datos genera información realmente accionable y, posteriormente, ampliar el proceso de forma progresiva.
¿Cómo prepara el terreno un software QHSE?
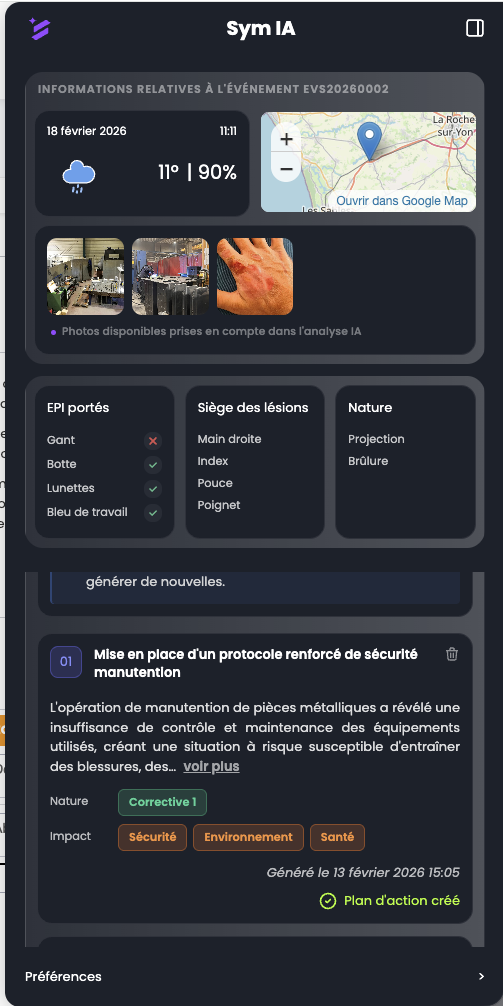
Una estrategia de Big Data QHSE no puede basarse en datos introducidos en formatos distintos según los equipos y los centros. El módulo de Gestión QHSE de Symalean centraliza de forma nativa las no conformidades, las auditorías, los indicadores y los planes de acción en una estructura homogénea, con la IA Sym AI que puede facilitar la detección de causas recurrentes en el historial ya recopilado. Es precisamente esta base estructurada la que hace posible una explotación avanzada de los datos en el futuro, en lugar de convertirse en un obstáculo constante que superar.