Perché i dati QHSE rimangono sottoutilizzati ?
Un dato riassume bene la sfida: il 20% degli incidenti gravi avviene durante il primo anno di lavoro, secondo un comunicato della FNATH pubblicato a novembre 2025.
Questo tipo di ricorrenza rimane tuttavia difficile da rilevare con gli strumenti classici (riunioni di sicurezza, affissioni, audit trimestrali) che hanno mostrato i loro limiti di fronte alla complessità sistemica degli ambienti di lavoro moderni. I dati esistono quasi sempre, semplicemente non vengono mai incrociati con abbastanza altre informazioni per rivelare questo schema.
Da dove provengono realmente i dati QHSE ?
Prima di parlare di analisi, è necessario mappare le fonti. Un'azienda genera tipicamente dati QHSE attraverso denunce di infortuni e incidenti, audit interni ed esterni, non conformità e piani d'azione, indicatori ambientali, formazione e abilitazioni, e segnalazioni dal campo tramite app mobile. Presa isolatamente, ognuna di queste fonti racconta una storia parziale. Collegate tra loro, permettono di vedere schemi invisibili a livello di un singolo indicatore.
Dall'analisi descrittiva all'analisi predittiva
La differenza tra un approccio QHSE tradizionale e uno basato sui Big Data si riduce a una domanda. L'analisi descrittiva risponde a "perché è successo", solitamente tramite un albero delle cause costruito dopo l'evento. L'analisi predittiva risponde a "dove rischia di succedere domani", incrociando continuamente variabili che sembravano prive di legami apparenti: condizioni meteo, ritmi di produzione, cicli di manutenzione dei macchinari. Un rapporto manuale che prima richiedeva settimane di compilazione Excel diventa, una volta centralizzati i dati, un'analisi quasi istantanea.
Il vantaggio non si limita al tempo risparmiato. Un'azienda che rileva un'anomalia comportamentale in tempo reale può bloccare una situazione pericolosa prima che si verifichi un incidente, invece di limitarsi ad analizzarla a posteriori. È questo passaggio, dal semplice constatare all'anticipare, a distinguere realmente un approccio Big Data QHSE da un comune cruscotto di indicatori.
Tre passaggi per costruire un approccio solido
Centralizzare prima di analizzare
Nessuna analisi seria è possibile finché i dati rimangono dispersi in strumenti scollegati tra loro. Il primo passo consiste nel raggruppare le fonti identificate in un repository comune, con una struttura omogenea : stessi campi, stesse unità di misura, stesso metodo per qualificare un evento da un sito all'altro.
Incrociare i dati invece di accumularli
Una volta centralizzati, i dati acquistano valore quando vengono incrociati tra loro. Un tasso di incidenti confrontato con i dati sulla formazione può rivelare che un sito non sta formando adeguatamente le proprie squadre su un rischio specifico. Un tasso di non conformità qualitativa rapportato al tasso di rotazione del personale può far emergere un legame che nessuno aveva ancora formalizzato.
Passare dalla constatazione alla previsione
L'ultima fase, spesso la più ambiziosa, consiste nell'utilizzare lo storico per anticipare anziché limitarsi a documentare. Individuare che un tipo di incidente si ripete sistematicamente in determinate condizioni permette di intervenire prima del prossimo evento, invece di continuare ad analizzarne le cause a posteriori.
Dati sensibili, da trattare con le precauzioni del GDPR
Costruire un approccio Big Data QHSE implica la gestione di dati relativi alla salute, agli infortuni e talvolta alla disabilità, che sono considerati dati sensibili ai sensi dell'articolo 9 del GDPR. Due precauzioni sono necessarie ancor prima di incrociare qualsiasi dato. La prima consiste nello scegliere la base giuridica corretta: il consenso del dipendente non è quasi mai appropriato, a causa del vincolo di subordinazione che lo lega al datore di lavoro. La seconda consiste nell'anonimizzare o pseudonimizzare i dati prima di qualsiasi trattamento su larga scala, affinché l'analisi delle ricorrenze rimanga possibile senza esporre l'identità delle persone coinvolte.
Approfondiamo questi metodi di anonimizzazione, la questione del consenso sul lavoro e il legame con l'AI Act per i sistemi predittivi applicati alla sicurezza nel nostro white paper sull'IA e la sicurezza sul lavoro.
L'errore da evitare all'inizio
La tentazione più comune è quella di voler costruire tutto subito: un data warehouse completo, dashboard sofisticate, modelli predittivi elaborati. Questo approccio porta quasi sempre a un progetto che si arena prima ancora della sua prima iterazione utile. È meglio iniziare con un perimetro ristretto, un sito o una famiglia di rischi, validare che l'incrocio dei dati produca informazioni realmente azionabili e poi estendere gradualmente l'iniziativa.
In che modo un software QHSE prepara il terreno ?
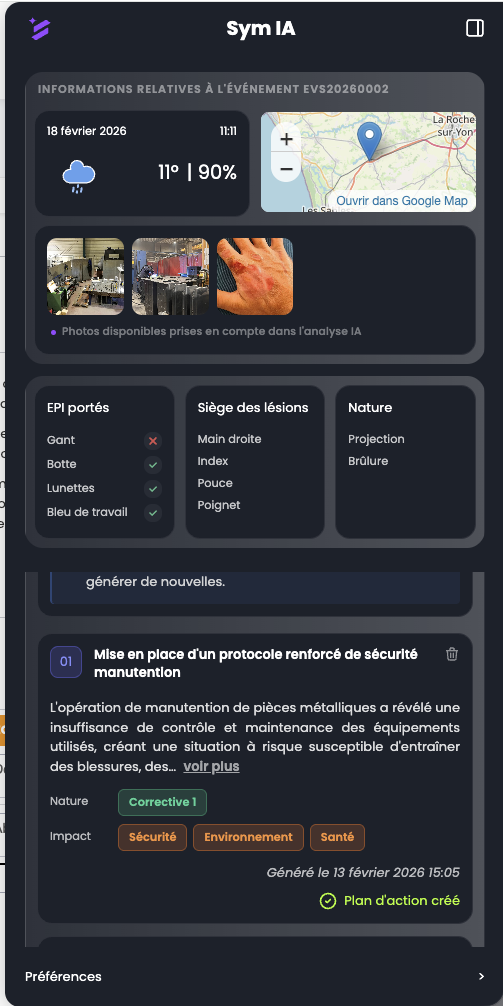
Un approccio Big Data QHSE non può basarsi su dati inseriti in formati diversi a seconda dei team e dei siti. Il modulo Gestione QHSE di Symalean centralizza nativamente non conformità, audit, indicatori e piani d'azione in una struttura omogenea, con l'IA Sym AI che può facilitare il rilevamento di cause ricorrenti sullo storico già raccolto. È proprio questa base strutturata a rendere possibile un successivo sfruttamento avanzato dei dati, evitando che diventi un ostacolo costante da superare.